A etiqueta meta robots es una directiva HTML a nivel de página que controla cómo los rastreadores manejan el comportamiento de rastreo, indexación y fragmentos, y el valor predeterminado es index, follow. He visto una línea noindex perdida que eliminó el tráfico de la noche a la mañana, generalmente en una página que alguien asumió que era "segura" porque solo existía en el <head>.
Esa es la parte que la gente se pierde cuando trata las directivas de robots como una casilla de verificación. En la práctica, la etiqueta es una superficie de depuración, y cuando rastreo una caída repentina, empiezo revisando el código fuente renderizado antes de culpar al contenido, los enlaces o "el algoritmo". Si te encuentras en esa misma situación, descubre por qué tu tráfico se desplomó es un compañero útil mientras inspeccionas la URL en sí, y normalmente lo combino con un vistazo rápido al historial a nivel de URL en las herramientas de estimación de tráfico de SemDash.
Tabla de contenido
- Cuando una etiqueta Meta Robots mata tu tráfico en silencio
- Las cuatro familias de directivas y lo que hace cada una
- Etiqueta Meta Robots vs Encabezado X-Robots-Tag
- Tres plantillas reales que uso en sitios de producción
- Cinco directivas que veo mal utilizadas cada semana
- La lista de verificación de auditoría de Meta Robots que ejecuto cada trimestre
- Solucionar los problemas y validar el resultado
Cuando una etiqueta Meta Robots mata tu tráfico en silencio
He recibido la misma llamada más veces de las que puedo contar. Una página que solía clasificar bien desaparece, el cliente jura que nada cambió y luego la exportación del rastreo muestra una sola línea en el encabezado, <meta name="robots" content="noindex">. Esa única línea es suficiente para eliminar una URL de los resultados de búsqueda porque la configuración predeterminada de Google sigue siendo index, follow, por lo que la etiqueta solo importa cuando deseas un comportamiento diferente. La propia documentación de Google mantiene esa estructura a nivel de página al frente y al centro, incluido el énfasis más reciente en el control a nivel de página en su actualización de robots de 2025, que es exactamente por qué la etiqueta sigue siendo importante en la gobernanza SEO moderna. la documentación de meta robots de Google
Por qué la trato como una palanca de depuración
El error no es usar la etiqueta. El error es tratarla como una configuración de plantilla que puedes olvidar. Una vez que un equipo agrega noindex, nofollow, o restricciones de fragmentos, esa directiva puede cambiar si una URL aparece en la búsqueda, si se siguen los enlaces de esa página y si los fragmentos o el contenido en caché aparecen en absoluto. Por eso veo la etiqueta como una superficie de control para la arquitectura, no como un ajuste cosmético de SEO.
Regla práctica: si una URL perdió visibilidad y el contenido no cambió materialmente, inspecciona primero la etiqueta head. He encontrado directivas de robots mal aplicadas en plantillas de staging, plantillas de página duplicadas e incluso páginas de detalles de productos que heredaron una regla de blog por accidente.
Las cuatro familias de directivas importan porque fallan de manera diferente. Directivas de indexación deciden si una página puede aparecer o no. Directivas de rastreo y enlaces dan forma a lo que se sigue. Directivas de fragmentos cambian lo que Google está dispuesto a mostrar en la SERP. Y controles a nivel de texto como data-nosnippet te permiten ocultar partes de una página sin cubrir toda la URL.
Por eso un flujo de depuración supera a una lista de verificación memorizada. Quiero saber qué vio el rastreador, qué mostró la SERP y qué plantilla emitió la etiqueta. Cuando esas tres cosas no coinciden, la etiqueta de robots suele ser la forma más rápida de explicar la diferencia.
Las cuatro familias de directivas y lo que hace cada una
Controles de indexación
Estas son las directivas que reviso primero cuando una página desaparece del índice. index permite la inclusión, noindex excluye la página y none es abreviatura de noindex, nofollow. Google también dice que el valor predeterminado ya es index, follow, por lo que el explícito index, follow suele ser redundante a menos que estés documentando la intención en una plantilla.
Un ejemplo limpio se ve así:
<meta name="robots" content="noindex,follow">
Eso le dice a los rastreadores que no indexen la página, pero que aún así les permitan seguir los enlaces de ella. Yo uso eso en páginas que quiero que se descubran pero no se clasifiquen, como páginas de utilidad delgadas o ciertos filtros. El modo de fallo es obvio en retrospectiva, pero no en el momento del despliegue. Alguien piensa que none significa “sin manejo especial” y la página desaparece.
Controles de rastreo y enlaces
follow y nofollow gobiernan si el rastreador debe seguir los enlaces de la página. En una página que necesita mantenerse fuera del índice pero aún así admitir el descubrimiento, generalmente prefiero noindex, follow en lugar de una opción general none porque esta última también bloquea el seguimiento de enlaces.
<meta name="robots" content="noindex,nofollow">
Esa versión elimina la página y suprime el seguimiento de enlaces. Es útil cuando la página en sí es un peso muerto, pero puede ser demasiado agresiva si la página aún contiene rutas internas valiosas. He visto a equipos romper rutas de rastreo al usar nofollow en páginas que se encuentran cerca de centros de categorías importantes.
Controles de fragmentos y fuentes
Google admite un conjunto separado de directivas de fragmentos, que incluyen nosnippet, max-snippet, max-image-preview, max-video-preview, y unavailable_after. nosnippet es el instrumento contundente. max-snippet:50 es un límite. max-image-preview:large y sus hermanos controlan el manejo de la vista previa. unavailable_after es una señal de eliminación programada.
data-nosnippet funciona de manera diferente porque se aplica a elementos de la página, no a la URL completa. Eso es útil cuando solo una parte de una página debe permanecer fuera de los fragmentos. Lo he usado en páginas donde un párrafo era sensible, pero el resto del contenido necesitaba permanecer completamente indexable.
Regla práctica: usa la directiva más específica que resuelva el problema real. Si solo necesitas ocultar un fragmento, no indexes la URL completa.
| Familia de directivas | Valores de ejemplo | Qué controla |
|---|---|---|
| Indexación | index, noindex, none |
Si la URL puede aparecer en la búsqueda |
| Rastreo y enlace | follow, nofollow |
Si se siguen los enlaces de la página |
| Fragmento | nosnippet, max-snippet:50, max-image-preview:large, unavailable_after |
Qué aparece en los SERP y durante cuánto tiempo |
| Control de origen a nivel de texto | data-nosnippet |
Elementos específicos de la página que no se pueden usar en fragmentos |
Etiqueta Meta Robots vs Encabezado X-Robots-Tag
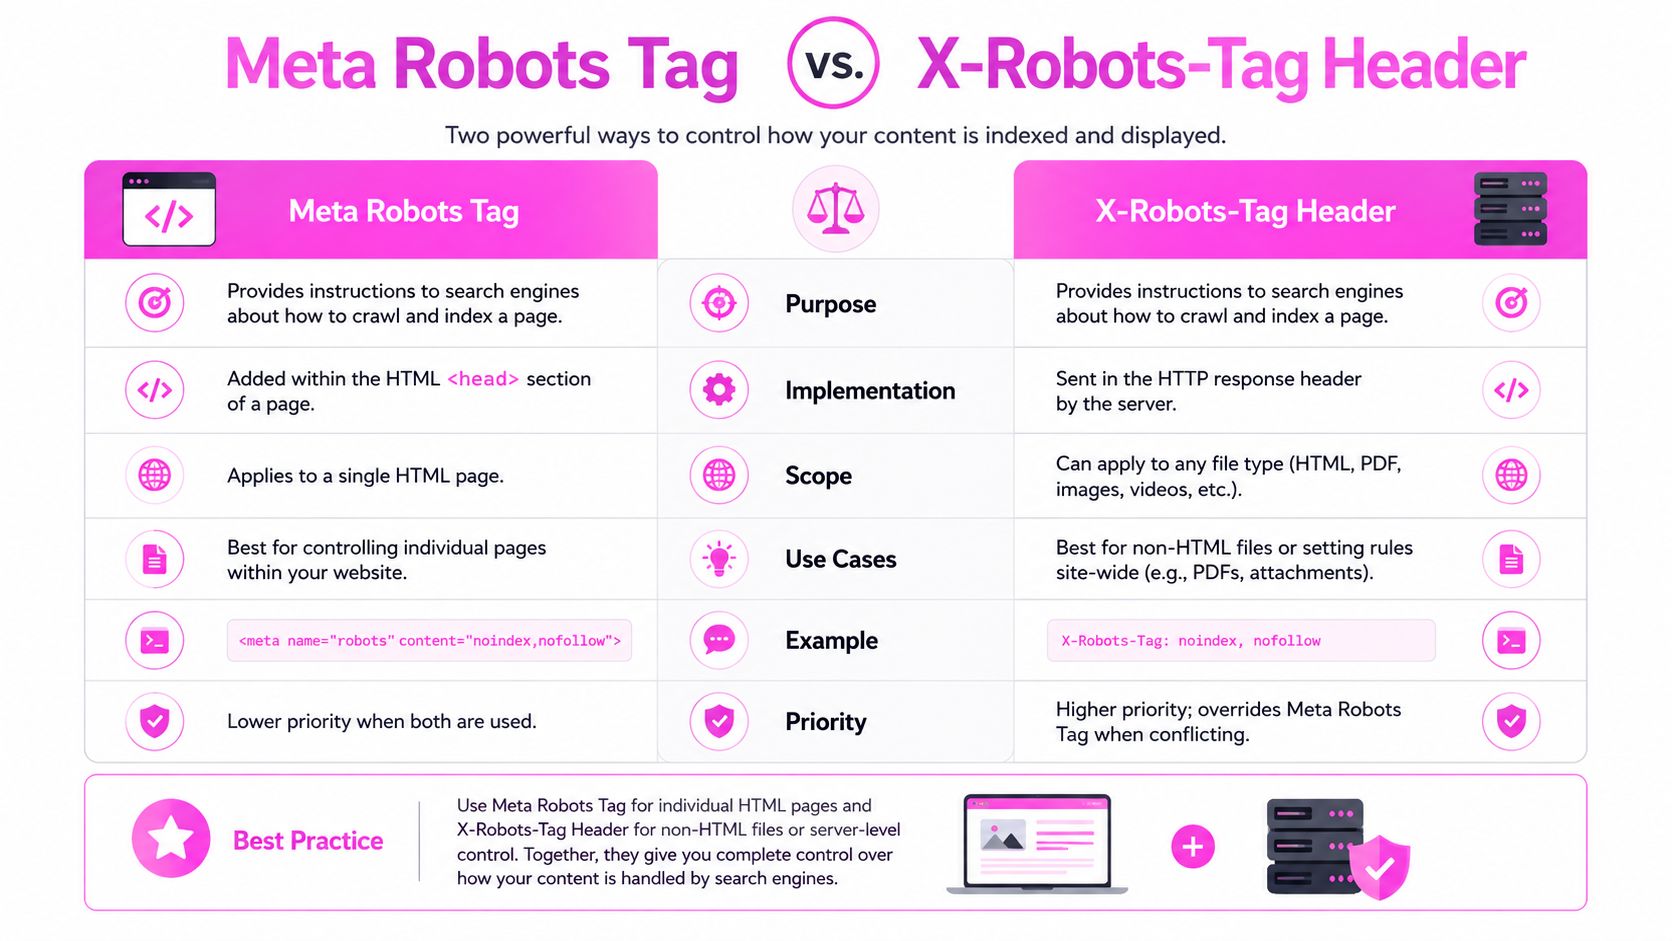
Una etiqueta meta robots en la propia página es la forma más rápida de controlar las URL HTML normales. La X-Robots-Tag encabezado resuelve los casos en los que no hay una cabecera HTML para editar, por lo que se adapta a PDF, imágenes y otros recursos que viven fuera del documento. La documentación de Google separa claramente esos usos, y también muestra que las directivas a nivel de página pueden viajar en un encabezado HTTP mientras que los controles a nivel de texto permanecen dentro del elemento de la página. Documentación de etiquetas especiales de Google
Dónde pertenece cada una
Trato la etiqueta como una decisión de plantilla y la cabecera como una decisión de capa de entrega. En Shopify, WordPress o cualquier aplicación renderizada en servidor, la metaetiqueta suele ser la ruta más limpia para el HTML. Para un PDF, no pierdo tiempo intentando forzar una cabecera en el archivo. Establezco la cabecera y sigo adelante.
Esa división importa aún más cuando ambas directivas apuntan a la misma URL. Google aplica la regla más estricta, por lo que una página con una instrucción que dice index y otra que dice noindex seguirá la versión restrictiva. El despliegue mixto es donde comienzan muchos errores de indexación, porque la página se ve bien en el CMS mientras el rastreador lee una directiva diferente del servidor o CDN.
Qué audito primero
Verifico tres cosas primero.
- Ubicación de entrega, si la directiva está en el HTML o en la cabecera.
- Tipo de activo, si la URL es una página normal o un archivo no HTML.
- Riesgo de colisión, si una plantilla de CMS, una regla de CDN o una configuración de servidor ya está enviando algo más estricto.
El mayor error operativo es asumir que la metaetiqueta y la cabecera son intercambiables. Resuelven diferentes problemas de implementación y, cuando ambas están presentes en la misma URL, el rastreador no negocia. Toma el camino más estricto.
En auditorías más grandes, mapeo esas directivas a los datos de rastreo a nivel de URL, luego comparo la salida en vivo con el comportamiento histórico de SERP usando SemDash y herramientas como la guía del rastreador SEO de Wispra. Ahí es donde suele aparecer la pérdida silenciosa de tráfico, una URL parametrizada desaparece, un PDF se desindexa o un cambio de plantilla envía noindex a páginas que debían permanecer visibles.
Tres plantillas reales que uso en sitios de producción
He implementado los mismos tres patrones una y otra vez porque resuelven problemas reales de indexación sin sobrecorregir. Son simples en la superficie, pero la diferencia entre una plantilla segura y una rota suele ser un atributo.
Navegación facetada que debe permanecer rastreable
Para filtros y URLs facetadas, suelo empezar con:
<meta name="robots" content="noindex,follow">
Eso mantiene la página fuera del índice y deja los enlaces internos descubribles. Es una buena opción cuando la página es útil como ruta de rastreo pero no como destino de clasificación. La señal de auditoría suele ser un clúster de URL desordenado en el historial de SERP, donde la misma intención comienza a rebotar entre URL parametrizadas y una de ellas desaparece repentinamente después de un cambio de plantilla.
Páginas de etiquetas delgadas generadas por una plataforma de blogs
Cuando un sistema de blogs genera docenas de páginas de etiquetas de bajo valor, a menudo usaré:
<meta name="robots" content="noindex,follow">
La razón es simple. Quiero que los motores de búsqueda sigan llegando al gráfico de artículos, pero no quiero que los archivos delgados compitan con el contenido real. Esto suele surgir después de que una revisión de mapeo a nivel de URL muestra que el archivo de etiquetas se está indexando mientras que el artículo subyacente está haciendo el trabajo.
Contenido restringido o que requiere inicio de sesión
Para contenido restringido, a menudo combinaré el control de eliminación con la supresión de fragmentos:
<meta name="robots" content="noindex,nosnippet">
Eso me da una página que no aparece en el índice y no filtra una vista previa. Es útil cuando el contenido está destinado a usuarios existentes, no a atraer tráfico de búsqueda público. El desencadenante suele ser una anomalía en el historial de SERP donde la página se clasifica para términos de marca, aunque claramente no está destinada a ser pública.
Si quieres una visión más amplia de cómo se comportan los rastreadores en las plantillas, la guía del rastreador SEO de Wispra es una referencia útil, especialmente cuando compruebas si el problema está en la representación, el descubrimiento o el manejo de directivas.
He descubierto que las notas del CMS importan tanto como la etiqueta en sí. Si la variable de plantilla está enterrada en una configuración de tema o en la configuración de ruta, la siguiente pasada de limpieza puede deshacer tu arreglo sin que nadie se dé cuenta.
Los tutoriales en vídeo ayudan cuando estás rastreando los mismos errores en varias plantillas.
Cinco directivas que veo mal utilizadas cada semana
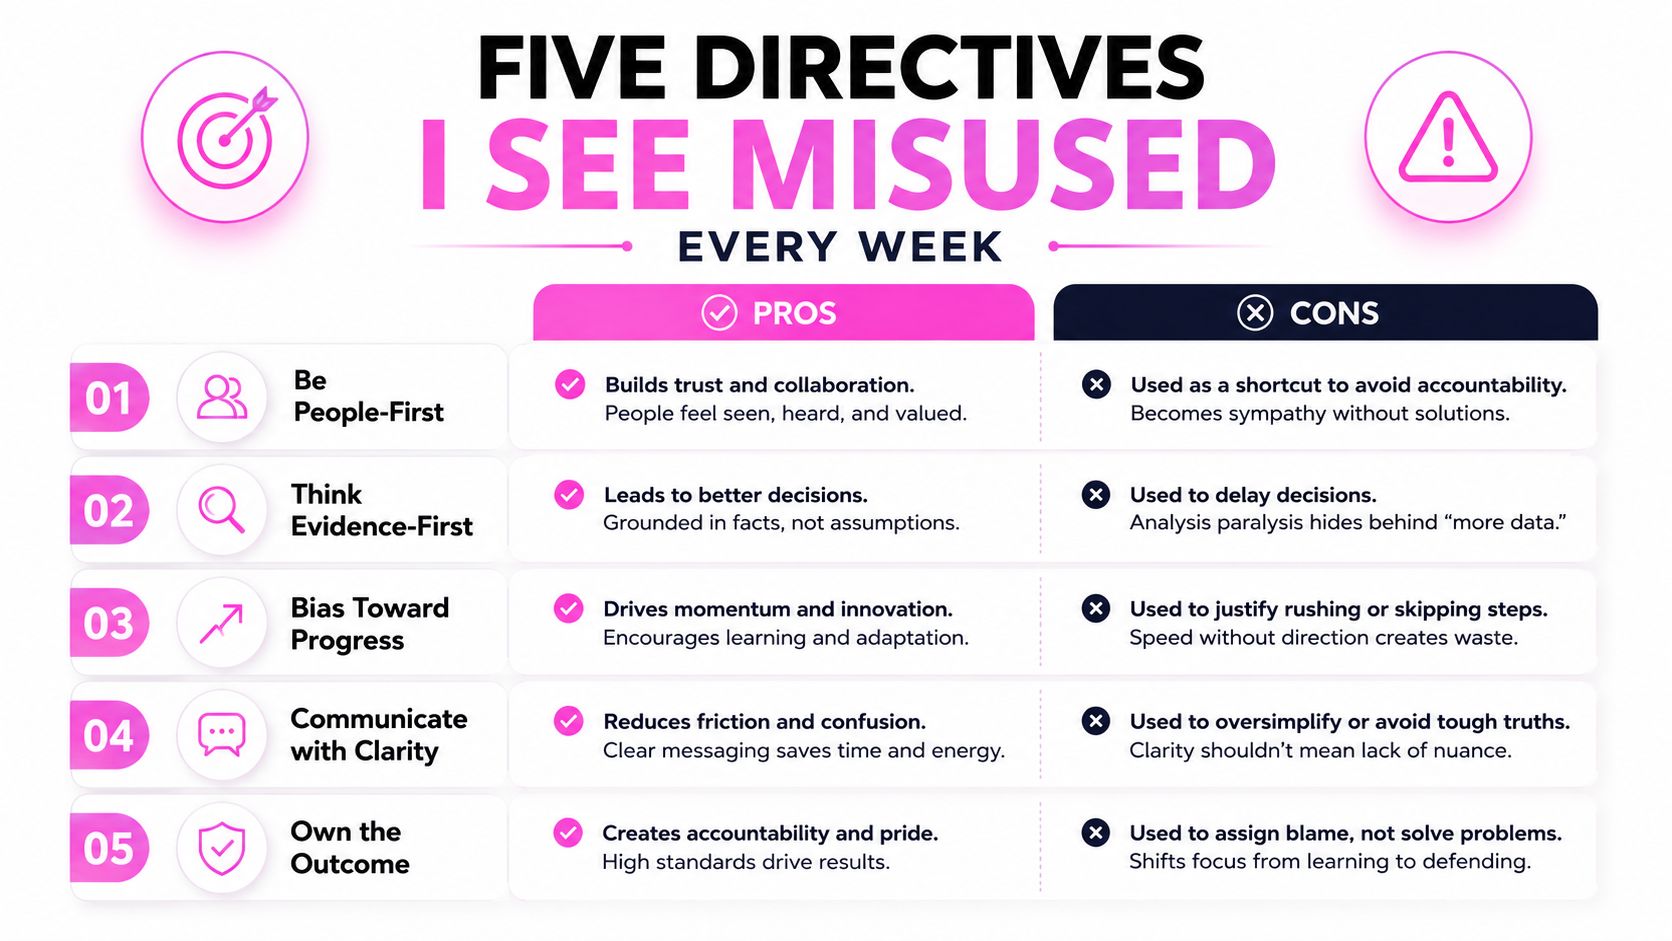
Los errores de robots más comunes no son dramáticos. Son pequeños desajustes entre la intención y la sintaxis, y se manifiestan como rarezas de indexación silenciosas que parecen un problema de posición hasta que revisas el código fuente.
Se sobrescribe el valor predeterminado sin motivo
Todavía veo plantillas que añaden explícitamente index, follow en todas partes. No es dañino, pero satura el código y complica las auditorías. Como el valor predeterminado de Google ya es index, follow, esas líneas rara vez solucionan algo.
Una versión mejor suele ser no incluir ninguna etiqueta meta robots. Si la página debe indexarse, el silencio es más limpio que el exceso de código.
El término abreviado que la gente malinterpreta
none es el que más confunde a los equipos. Significa no “sin trato especial”. Significa noindex, nofollow. He visto desaparecer un archivo entero porque alguien asumió que none era un comodín neutral.
El conflicto que termina mal
Una etiqueta genérica robots y una específica para rastreadores googlebot Las etiquetas se pueden combinar y Google usará el resultado más restrictivo. Eso es genial cuando quieres una excepción solo para Google, pero es peligroso cuando el equipo olvida que la regla general sigue activa.
Un patrón roto se ve así:
<meta name="robots" content="index">
<meta name="googlebot" content="noindex">
Google interpreta eso como noindex. Si el dueño del sitio esperaba que ganara la regla general, la sorpresa suele ser una caída de tráfico y mucha confusión.
El control de fragmentos que no oculta la página
max-snippet:0 se usa a menudo como un interruptor de ocultación. No lo es. Si el objetivo es eliminar por completo la vista previa de la página, nosnippet es la directiva directa. He visto equipos usar max-snippet:0 y luego preguntarse por qué el resultado seguía comportándose de manera diferente a un fragmento completamente suprimido.
La página paginada que se sobreoptimiza
Marcar URLs paginadas como noindex es una reacción exagerada común. Puede eliminar rutas de descubrimiento útiles y hacer que toda la serie sea más difícil de acceder mediante el flujo de rastreo. He visto cómo rompe el descubrimiento en grandes sistemas de archivo donde la capa paginada era la única ruta confiable hacia contenido más profundo.
Regla que uso: si una directiva está diseñada para ocultar la visibilidad, asegúrate de que realmente oculte la capa que te importa. El control de fragmentos no es control de indexación, y el control de indexación no es diseño de rutas de rastreo.
La lista de verificación de auditoría de Meta Robots que ejecuto cada trimestre
La primera pasada siempre es mecánica. Exporto cada URL rastreable, luego filtro por páginas que contengan alguna etiqueta meta robots, ya que el estado por defecto suele ser sin etiqueta. A partir de ahí, comparo la lista de directivas con lo que el historial de las SERP y el mapeo a nivel de URL dicen que hizo la página con el tiempo, ya que ahí es donde los fallos silenciosos aparecen primero. El markdown api se vuelve útil para los equipos que necesitan una extracción limpia de HTML a texto durante auditorías masivas, especialmente cuando las páginas de origen son desordenadas o tienen plantillas pesadas.
Lo que reviso en orden
- Primero la exportación del rastreo. Marca cada URL con cualquier directiva de robots y separa las etiquetas HTML de los encabezados.
- Luego el historial de las SERP. Comparo la intención de la directiva con las señales de visibilidad de los últimos 12 meses para encontrar páginas que no coinciden con su estado actual.
- Escaneo de colisiones. Compruebo si hay metaetiquetas y cabeceras X-Robots-Tag en conflicto en la misma URL.
- Anulaciones específicas para rastreadores. Verifico que
googlebotlas reglas no estén anulando la reglarobotsgenérica. - Cruce de señales. Reviso el movimiento del tráfico orgánico, los dominios de referencia y las menciones en los Resúmenes de IA para detectar páginas que están demasiado restringidas.
Lo que la discrepancia suele significar
Si una página está marcada como noindex pero sigue posicionándose, suelo encontrar una caché desactualizada, un problema de renderizado o un conflicto entre la cabecera y el head. Si una página no tiene directiva y desaparece de repente, primero busco un problema de herencia en la plantilla. Cuando la página es importante y el mapeo cambia sin que haya un lanzamiento de contenido, es una clara señal de que la regla de robots se añadió en algún lugar invisible para el equipo de contenido.
También vigilo los grupos de páginas que deberían haberse mantenido abiertas para el descubrimiento pero que se restringieron durante un sprint de limpieza. Esas son las que pierden alcance interno mientras todos celebran la plantilla "más controlada".
El flujo de trabajo de optimización de contenido de SemDash es útil cuando necesito conectar los hallazgos de robots con el rendimiento general de las páginas, ya que un error de directiva rara vez se queda aislado en una sola URL.
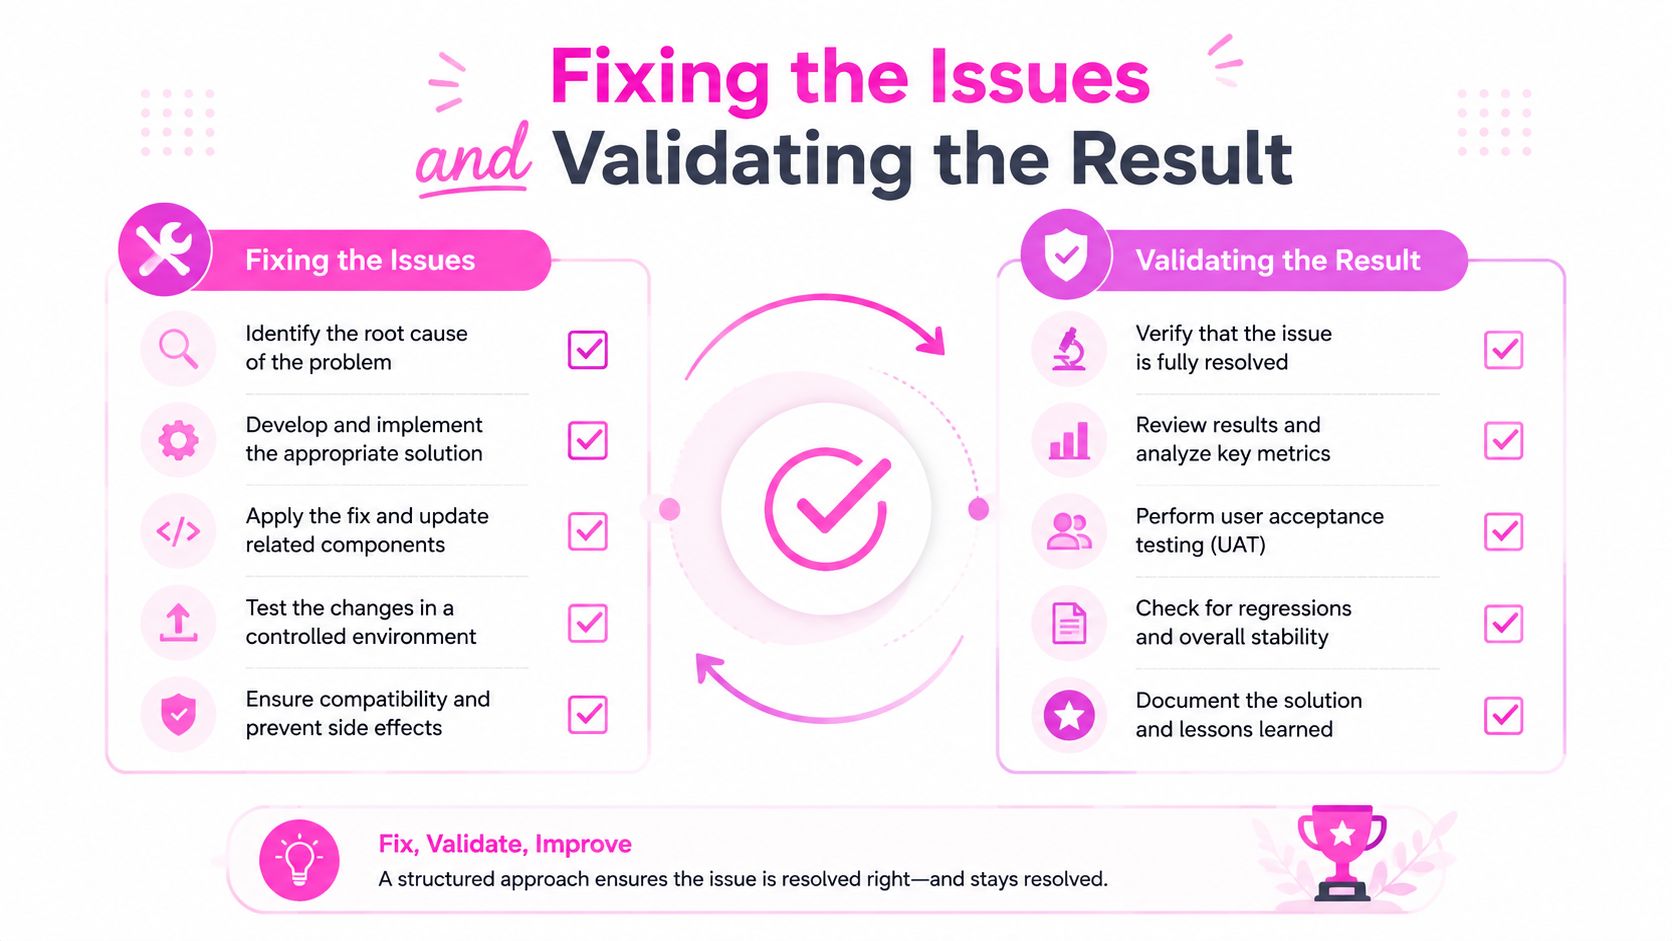
Solucionar los problemas y validar el resultado
Primero arreglo las URL con valor real, aquellas que ya habían conseguido enlaces o tenían una fuerte demanda de búsqueda antes de que cambiara la directiva. Luego aplico la solución a través de la capa de plantilla o cabecera, no editando páginas individuales una por una, porque las correcciones aisladas se pierden la próxima vez que se actualiza el CMS. Las implementaciones más limpias son aquellas en las que el motivo de la directiva queda documentado justo al lado de la regla.
Cómo verifico la solución
Monitoreo la URL en el historial de las SERP y en las vistas de mapeo, y luego confirmo que la fuente renderizada o las cabeceras de respuesta hayan cambiado. Si la página estaba bloqueada antes, espero ver que el estado de indexación cambie solo después de que el rastreador vuelva a procesar la URL. Por eso no confío solo en guardar una plantilla.
El ciclo de validación es sencillo:
- Confirma que la directiva ya no está o ha sido corregida en el código fuente o en las cabeceras.
- Vuelve a rastrear la URL y comprueba si el estado en las SERP cambia.
- Vigila las colisiones adyacentes, porque los arreglos en las plantillas pueden afectar a URLs hermanas si la regla es demasiado amplia.
- Deja una nota en la plantilla, para que el siguiente ingeniero sepa por qué existe la directiva.
Regla práctica: si una página no necesita una etiqueta meta robots, no la pongas. Si realmente necesita una, documenta la razón en el lugar donde vive la plantilla.
De lo que se trata es de detener el daño SEO invisible antes de que se acumule. Ese es el valor de un flujo de trabajo de robots estricto, y por eso prefiero validar con la página misma en vez de confiar en suposiciones, capturas de pantalla o en la memoria de alguien.
Si quieres una forma más limpia de detectar errores en las directivas de robots antes de que arruinen tu tráfico, usa SemDash para mapear la visibilidad a nivel de URL, rastrear el historial de SERP y detectar cambios en la indexación mientras aún se pueden solucionar. Es la forma más rápida que conozco para conectar una anomalía de rastreo con la página exacta que la causó y luego demostrar que la solución funcionó.