La mayoría de los consejos sobre datos estructurados para SEO empiezan con “añade schema y obtén resultados enriquecidos”. Esa es la parte que causa la mayor pérdida de tiempo. He visto equipos implementar marcado de Organización, Artículo, BreadcrumbList y Producto en miles de URLs, y luego esperar un cambio visible que nunca apareció.
El despliegue no fue necesariamente inútil. El modelo de medición estaba incompleto. Los datos estructurados pueden hacer que el contenido sea comprensible para los motores de búsqueda, respaldar la elegibilidad para resultados enriquecidos, aclarar las relaciones entre entidades y exponer fallos de implementación en un sitio. La documentación de Google es explícita en que los datos estructurados no son un factor de clasificación directo, pero pueden ayudar a la Búsqueda a comprender una página y determinar si la página califica para un formato de resultado más enriquecido, como se explica en Introducción a los datos estructurados de Google.
La pregunta práctica no es “¿Pegamos el esquema en la plantilla?”. Es “¿Qué puede entender, validar y usar con confianza un motor de búsqueda de esta página?”
Tabla de contenido
- Lo que realmente hacen los datos estructurados en un sitio web activo
- Marcado de Esquema Explicado Sin Jerga
- Tipos de esquema que valen la pena en 2026
- Elegir un formato y enviar el marcado de la manera correcta
- La cobertura es el verdadero problema, no la presencia
- Pruebas, depuración y supervisión de datos estructurados
- Uso de herramientas de investigación SEO para priorizar el trabajo de Schema
- Tu lista de verificación de datos estructurados y qué ver a continuación
Lo que realmente hacen los datos estructurados en un sitio web activo
En un despliegue de editor, el equipo había implementado varios tipos de esquemas en una gran biblioteca de contenido. El marcado estaba presente, las plantillas se renderizaron y los desarrolladores consideraron el proyecto completo. Los resultados enriquecidos no llegaron de la manera que esperaban los interesados, por lo que el proyecto se etiquetó inicialmente como un fracaso.
No estuve de acuerdo con esa conclusión, pero tampoco llamaría exitoso al despliegue. El equipo había tratado los datos estructurados como un solo trabajo, cuando en realidad estaba realizando al menos tres trabajos diferentes con criterios de éxito muy distintos.
Etiqueta entidades en lugar de adivinar
El primer trabajo es identificación de entidades. Una página puede mencionar una marca, un producto, un autor, una práctica médica o el tema de una reseña cuyo nombre se parece a otras entidades en la web. El esquema proporciona a las máquinas etiquetas explícitas como Organization, Producto, Persona, Article, y Revisar.
Eso no demuestra mágicamente cada declaración en la página. Sí crea una capa de datos más clara. Un Article puede apuntar a un Persona autor, un Producto puede apuntar a un Offer, y un Organization puede conectarse a perfiles autorizados a través de sameAs. Esas relaciones son más útiles que un bloque plano que solo repite el título de la página.
Soporta la interpretación automática más allá de la SERP
El segundo trabajo es menos visible. Los datos estructurados pueden ayudar a los sistemas a interpretar de qué trata una página, incluso cuando no aparece ninguna mejora visual en los resultados de búsqueda. Esto es importante ya que las interfaces de búsqueda resumen, comparan y responden cada vez más en lugar de mostrar solo diez enlaces azules.
No trato el esquema como una ruta garantizada para obtener respuestas generadas por IA. Ninguna marca puede obligar a un sistema a citar una página. Lo trato como una forma de reducir la ambigüedad, especialmente cuando la página incluye entidades conectadas, autoría clara, fechas, productos u información organizacional.
Expone problemas de calidad
El tercer trabajo es operativo. El marcado limpio obliga a un equipo a responder preguntas incómodas. ¿Quién escribió el artículo? ¿Qué imagen representa el producto? ¿Es el precio mostrado el mismo que el precio estructurado? ¿El breadcrumb refleja la jerarquía real?
Regla práctica: Los datos estructurados deben describir la página que reciben los usuarios, no el resultado que esperas que muestre Google.
Después de que el editor cambiara su proceso de revisión de "¿Está presente el script?" a "¿Puede el motor analizar las entidades y relaciones previstas?", el equipo encontró inconsistencias en las plantillas que las comprobaciones SEO ordinarias habían pasado por alto. Ese cambio es la base para evaluar los tipos de esquema por el valor real del negocio en lugar de por lo impresionante que parezca un despliegue en el código fuente.
Marcado de Esquema Explicado Sin Jerga
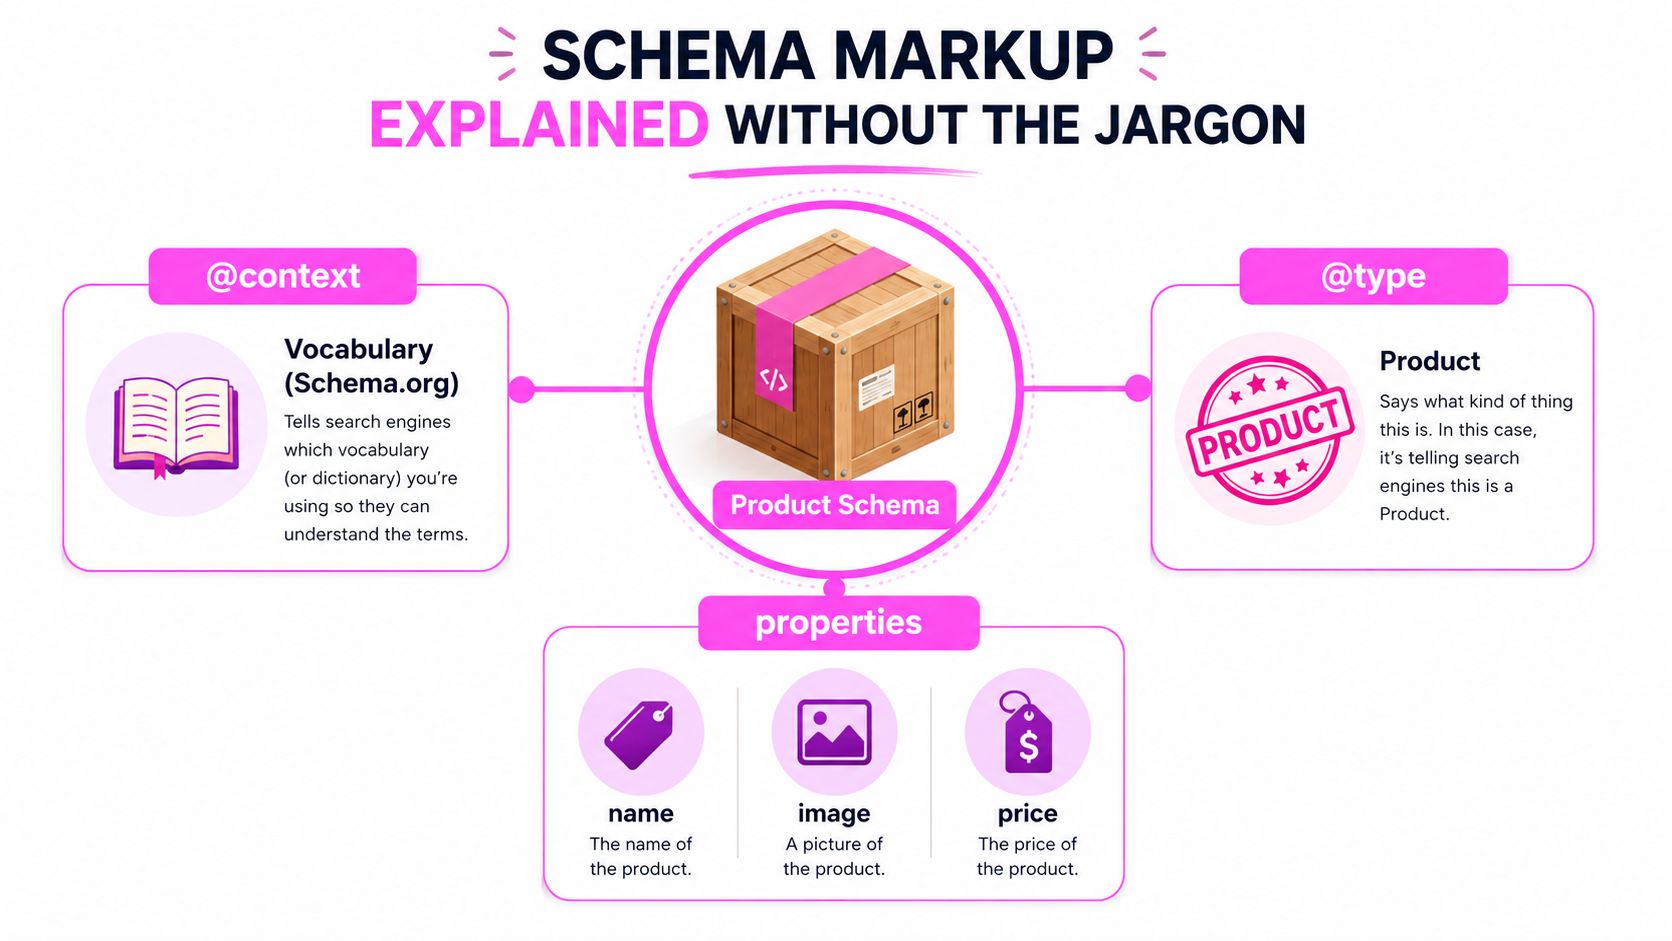
Piensa en un bloque de esquema como una caja de envío con etiquetas. La caja contiene información sobre una cosa o varias cosas relacionadas. Las etiquetas exteriores indican a una máquina qué vocabulario estás utilizando y qué tipo de objeto ha recibido.
@contextidentifica el vocabulario, normalmente Schema.org.@typeidentifica la cosa, comoArticle,Producto, oOrganization.- Las propiedades identifican sus partes, como
name,image,author, oprice.
Un objeto de artículo mínimo podría parecer conceptualmente así:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "A Practical Guide to Structured Data"
}
</script>
El tipo le dice al analizador que esto es un artículo. El titular le da una propiedad con nombre. Eso es suficiente para entender la forma básica, pero el marcado de producción normalmente necesita más contexto:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "A Practical Guide to Structured Data",
  "author": {
    "@type": "Person",
    "name": "Alex Morgan"
  },
  "datePublished": "2026-08-20",
  "image": "https://example.com/images/structured-data.jpg"
}
</script>
El anidado author objeto importa porque el autor es una persona, no solo una cadena de texto no calificada. Esa distinción permite a un sistema comprender la relación entre el artículo y su creador.
¿Por qué JSON-LD suele ser mi opción predeterminada?
Google recomienda JSON-LD como el formato de datos estructurados preferido. El formato se encuentra en un elemento de script, separado del HTML visible, por lo que los ingenieros pueden generarlo a partir de campos de CMS sin tener que tejer atributos en cada elemento de contenido. La galería de datos estructurados de Google también describe JSON-LD como un formato recomendado que se coloca en la cabeza o el cuerpo.
Microdata y RDFa pueden funcionar, pero vinculan los metadatos más estrechamente al marcado de la página. Eso aumenta el riesgo de mantenimiento cuando los diseñadores cambian la estructura HTML o los nombres de los componentes. Para los equipos que crean plantillas de esquema en muchas URL, la separación facilita la auditoría y la implementación.
Los fallos comunes son fáciles de reconocer:
- Falta una propiedad obligatoria, por lo que el elemento puede no calificar para un resultado enriquecido.
- A
Productose declara como unArticle, por lo que las propiedades describen la entidad incorrecta. - Un objeto anidado se reduce a una cadena, como el nombre de un autor sin identificar al autor como un
Persona. - Un precio, reseña o fecha en JSON-LD no coincide con lo que los usuarios pueden ver.
El esquema es metadatos, no contenido. Debe aclarar el contenido visible y las relaciones. No debe introducir afirmaciones, ofertas, reseñas o respuestas que la página no admita. Si tu trabajo implica hacer que las entidades sean comprensibles en industrias complejas, esta guía práctica sobre SEO con IA para consultorios médicos es un compañero útil porque la claridad de la entidad se vuelve especialmente importante cuando los servicios, los profesionales y las ubicaciones se superponen.
Tipos de esquema que valen la pena en 2026
Clasifico los tipos de esquema por el resultado que pueden respaldar, no por la frecuencia con la que un plugin los ofrece. La documentación de Google deja clara la distinción clave: los datos estructurados pueden habilitar resultados enriquecidos, pero no son en sí mismos una señal de clasificación directa. El tipo solo importa cuando la página es elegible, el marcado es preciso y la experiencia de búsqueda aún muestra esa característica.
| Tipo de esquema | ¿Resultado enriquecido en 2026? | Valor SEO principal | Error común |
|---|---|---|---|
| Producto con oferta | Sí, donde sea elegible | Visibilidad del producto, precio, disponibilidad y contexto comercial | Emitir campos de oferta obsoletos o en blanco |
| Reseña o AggregateRating | Sí, donde sea elegible | Presentación de reseñas y contexto de confianza | Marcar reseñas que no cumplen los requisitos de la política |
| Receta | Sí, donde sea elegible | Presentación de búsqueda específica de recetas | Aplicar campos de recetas a artículos genéricos de comida |
| Evento | Sí, donde sea elegible | Fechas, ubicaciones y descubrimiento de eventos | Dejar eventos cancelados o caducados activos |
| LocalBusiness | Sí, donde sea elegible | Identidad del negocio, ubicación y contexto del servicio | Usar un único objeto de negocio genérico para cada ubicación |
| JobPosting | Sí, donde sea elegible | Visibilidad de búsqueda de empleo | Mantener vacantes cubiertas o caducadas activas |
| VideoObject | Sí, donde sea elegible | Descubrimiento de vídeo y presentación mejorada | Falta la relación real del vídeo |
| Organization | Generalmente indirecto | Desambiguación de marca y entidad | Nombres, logotipos o inconsistentes sameAs perfiles |
| BreadcrumbList | Generalmente indirecto | Jerarquía del sitio y comprensión de la navegación | Generar migas de pan que no coinciden con la navegación visible |
| WebSite con SearchAction | Generalmente indirecto | Relación de búsqueda interna y contexto de enlaces del sitio | Apuntar a una URL de búsqueda que no funciona |
| Article con autor | A veces elegible | Tipo de contenido, autoría y contexto editorial | Usar autores de marcador de posición o fechas inexactas |
| Persona | Generalmente indirecto | Claridad de la entidad del autor y del experto | Crear entidades de persona duplicadas para un autor |
| FAQPage | El beneficio visual se ha reducido | Relaciones de preguntas y respuestas legibles por máquina | Esperar bloques de preguntas frecuentes expandibles automáticamente |
| HowTo | El beneficio visual se ha reducido | Estructura instructiva y legibilidad por máquina | Añadirlo a contenido que no es un tutorial real |
Tipos de alto rendimiento
Para comercio electrónico, Producto combinado con precisión Offer los datos merecen atención temprana. La implementación debe reflejar el nombre visible del producto, precio, disponibilidad e imagen. Recetas, eventos, negocios locales, empleos y videos también pueden justificar trabajo enfocado cuando la página representa con precisión esa entidad y cumple con los requisitos documentados de Google.
de Google políticas de datos estructurados advierten que faltar propiedades requeridas puede hacer que un elemento no sea elegible. Por eso prefiero implementar un conjunto más pequeño de objetos de producto completos en lugar de emitir cada propiedad posible con valores vacíos.
Los tipos indirectos son cada vez más valiosos
Organization, Persona, BreadcrumbList, y las entidades de artículos conectados a menudo no producirán un cambio visual dramático. Aún ayudan a establecer quién publica contenido, cómo encajan las páginas en el sitio y qué perfiles externos representan la misma entidad.
Tengo especial cuidado con sameAs. Debe apuntar a perfiles autorizados que representen a la organización o persona. No es un lugar para agregar todas las URL de redes sociales que un especialista en marketing pueda encontrar.
Las preguntas frecuentes y el "cómo" necesitan una expectativa diferente
Los tipos de preguntas frecuentes y "cómo" se han promocionado en exceso porque las guías anteriores se centraban en bloques de resultados de búsqueda expandibles. La cobertura de los cambios de Google informa que Google eliminó los resultados enriquecidos de preguntas frecuentes el 7 de mayo de 2026, después de restricciones anteriores, mientras que muchos sitios continúan conservando el marcado de FAQPage para la interpretación legible por máquina. La cobertura relevante de los cambios de datos estructurados de Google enmarca la oportunidad restante en torno a la claridad de la entidad, la búsqueda interna y el potencial de citación de IA en lugar de una característica garantizada en los SERP.
Mantengo el marcado de preguntas frecuentes cuando las preguntas y respuestas son visibles y útiles. Lo elimino cuando un complemento crea preguntas genéricas y duplicadas en URL no relacionadas. La decisión es editorial y operativa, no sentimental.
Elegir un formato y enviar el marcado de la manera correcta
Utilizo JSON-LD de forma predeterminada porque Google lo recomienda y porque mantiene los datos estructurados separados del código de presentación. Microdata y RDFa siguen siendo formatos válidos, pero su acoplamiento con HTML hace que los cambios grandes en las plantillas sean más difíciles de revisar.
| Criterio | JSON-LD | Microdata | RDFa |
|---|---|---|---|
| Ubicación | Script en el head o body | Atributos dentro de HTML | Atributos dentro de HTML |
| Mantenimiento | Centralizado y compatible con plantillas | Vinculado al marcado visible | Vinculado al marcado visible |
| Ajuste de ingeniería | Fuerte para CMS y sistemas de componentes | Útil cuando los metadatos deben seguir a los elementos | Útil para sistemas ya construidos en torno a RDFa |
| Capacidad de auditoría | Fácil de extraer y comparar | Requiere analizar el HTML de la página | Requiere analizar el HTML de la página |
| Elección predeterminada | Por lo general, mi recomendación | Situacional | Situacional |
Un flujo de despliegue que sobrevive a la escala
Empiezo por definir el modelo de entidad. Para una página de producto, eso podría incluir Producto, Offer, Brand, e información de reseñas seleccionada. Para un artículo, puede incluir Article, Persona, Organization, ImageObject, y migas de pan.
Luego mapeo cada propiedad a un campo de origen confiable:
- Elige la fuente. Extrae el título, el autor, la imagen, el precio y las fechas de los campos del CMS o de una base de datos de productos.
- Generar de forma condicional. No imprimas propiedades vacías solo porque una librería de esquemas las admita.
- Renderizar de forma centralizada. Coloca JSON-LD en un diseño o componente de página compartido, no en el cuerpo del texto escrito a mano.
- Comparar entornos. Crea una diferencia de esquema previa a la producción que resalte los tipos, identificadores y propiedades requeridas que hayan cambiado.
- Lanzar de forma selectiva. Empieza con plantillas representativas y luego amplía después de la validación.
A menudo uso un formateador de JSON como este herramienta gratuita de formato JSON para inspeccionar la salida generada durante el desarrollo. No sustituye a las herramientas de prueba de Google, pero hace que el anidamiento mal formado y los valores de cadena accidentales sean más fáciles de detectar.
Los problemas de políticas causan más daños que los errores de sintaxis
Google dice que las páginas de datos estructurados deben seguir siendo accesibles y advierte contra su bloqueo con robots.txt, noindex, u otros controles de acceso. La página también debe mostrar la información que describe el marcado. Los datos de reseñas son particularmente sensibles. No marques una relación de reseña que la página visible no admita, y no coloques marcado de reseñas de productos en una página que solo contenga elogios generales sobre una categoría.
Un documento JSON válido aún puede representar una implementación no elegible o engañosa. La sintaxis es la primera puerta, no la aprobación final.
La cobertura es el verdadero problema, no la presencia
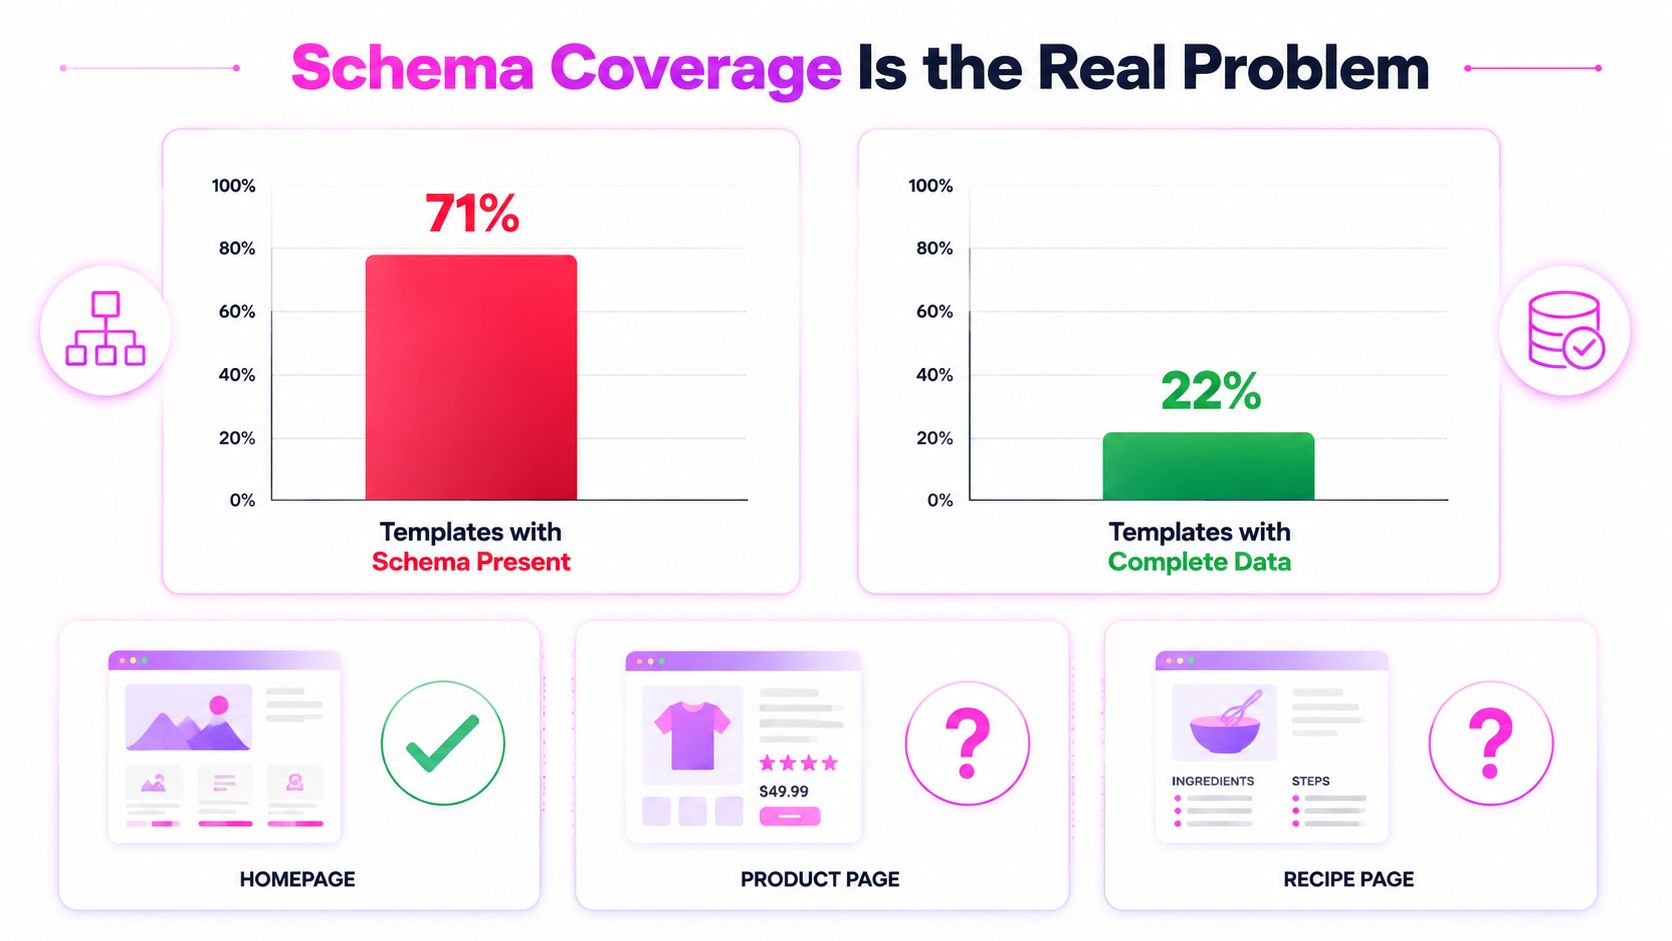
Una página de inicio con esquema de Organización no demuestra que tu sitio tenga un programa de datos estructurados. Las páginas de productos pueden no emitir nada. Las páginas de recetas pueden generar objetos incompletos. Las plantillas de preguntas frecuentes pueden crear marcado duplicado con respuestas vacías. Aún así, un informe del CMS puede decir: "Esquema habilitado".
Una auditoría independiente de 2026 informó que el 71% de los sitios usaba al menos un tipo de esquema, mientras que solo el 22% superó la Prueba de resultados enriquecidos sin errores en cada @type que emitieron. Esas cifras están documentadas en el auditoría de adopción e implementación de datos estructurados (schema). La brecha apunta a un problema de cobertura y calidad, no a una falta de conocimiento sobre schema.
Audita URLs, no plantillas
Una revisión a nivel de plantilla responde si el código existe. Una revisión a nivel de URL responde si el código recibe los campos que necesita.
Para cada tipo de schema, armo un inventario sencillo:
- URLs elegibles
- URLs que emiten el tipo previsto
- URLs que superan la validación
- URLs con advertencias o propiedades faltantes
- URLs bloqueadas, con etiqueta noindex o inaccesibles
Luego calculo una proporción de elegibilidad frente a despliegue para cada tipo. La proporción exacta importa menos que separar el total de URLs elegibles de aquellas que por casualidad tienen marcado. Una plantilla de producto puede estar habilitada técnicamente mientras que a la mayoría de los productos les faltan imágenes, ofertas o reseñas.
Arregla primero las brechas más grandes
Rastreo el sitio con un crawler compatible con schema y agrupo los fallos por plantilla y categoría de error. Una plantilla de producto a la que le falta el campo de precio merece más atención que una página de poco tráfico que usa un tipo opcional a la perfección.
Mi priorización es:
- Rastrea todas las clases de URL elegibles.
- Agrupa las URL por campo faltante y rama de plantilla.
- Prioriza las páginas de ingresos y las páginas vinculadas a consultas de muchas impresiones.
- Corrige las fuentes de datos antes de añadir nuevos tipos de esquemas.
- Vuelve a comprobar la cobertura tras el despliegue.
Detengo la ampliación del catálogo de esquemas hasta que la cobertura actual supere el 80%, utilizando ese umbral como un objetivo operativo interno en lugar de un requisito de Google. La presencia es una casilla de verificación. La cobertura te indica si el sistema funciona en las páginas que importan.
Pruebas, depuración y supervisión de datos estructurados
Una página de producto falló una vez en la prueba de resultados enriquecidos con un price invalid error. La página se veía correcta para un visitante porque el componente visible de precio de oferta gestionaba un valor vacío del CMS sin problemas. La rama JSON-LD no lo hizo. Serializó el campo de oferta en blanco como el precio de la oferta.
Reproduje la URL en la documentación y el flujo de trabajo de la prueba de resultados enriquecidos de Google, luego inspeccionó el JSON-LD analizado en lugar de solo el código fuente de la página. La prueba es compatible con JSON-LD, RDFa y Microdatos, y muestra qué tipos de resultados de Google puede generar la página.
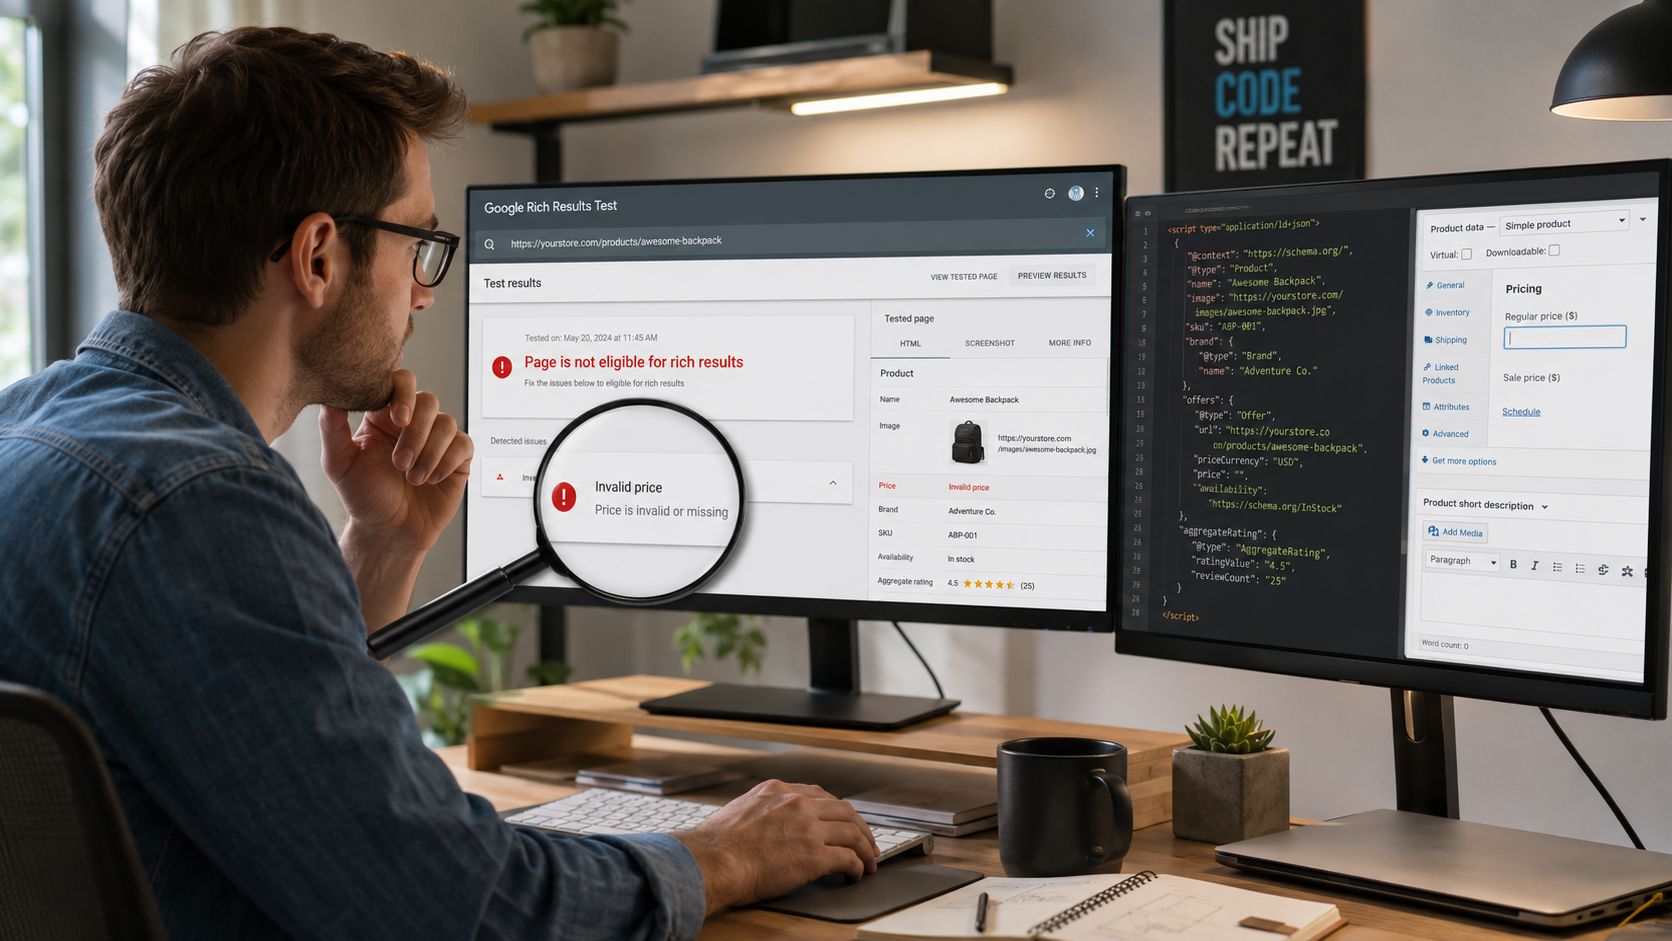
La ruta de depuración
El valor en blanco se debía a una rama de plantilla condicional que solo se activaba para los productos en oferta. La solución no fue eliminar la price propiedad. Corregimos el respaldo para que la oferta estructurada heredara el precio de lista cuando el campo de precio de oferta estaba vacío, manteniendo al mismo tiempo la propia lógica de precios de la página visible.
Tras la nueva implementación, volví a verificar el objeto analizado. También consulté el Validador de Marcado de Esquema, ya que la elegibilidad de Google y la validez de Schema.org responden a preguntas relacionadas pero diferentes. Una confirma lo que Google puede usar para resultados enriquecidos compatibles. La otra ayuda a identificar problemas de vocabulario y estructura de forma más general.
Una buena secuencia de depuración es:
- Reproduce el fallo. Prueba la URL en vivo y la versión de prueba.
- Inspecciona el resultado analizado. Busca cadenas vacías, tipos de datos incorrectos y anidamientos inesperados.
- Rastrea el campo de origen. Sigue el valor a través de la lógica del CMS y las ramas condicionales.
- Actualiza la plantilla. Corrige la ruta de datos, no solo la URL afectada.
- Vuelve a desplegar y realiza pruebas de nuevo. Confirma que el error desaparece en el resultado analizado.
- Revisa Search Console. Revisa los informes de mejoras en busca de patrones recurrentes.
El siguiente video es útil cuando una guía visual ayuda a explicar la interfaz de pruebas.
La monitorización detecta desviaciones silenciosas
Utilizo tres capas de monitorización. Las plantillas comerciales críticas reciben comprobaciones casi en tiempo real durante los lanzamientos. Un lote semanal valida URLs representativas y vigila los cambios en los recuentos de elementos válidos e inválidos. Un rastreo mensual mide la cobertura en todo el inventario de URLs.
El flujo de informes de Search Console permite a los propietarios de sitios rastrear cómo cambian los elementos de datos estructurados válidos e inválidos con el tiempo. No interpreto cada advertencia como una emergencia, pero sí investigo cambios repentinos, especialmente después de lanzamientos de CMS, precios, navegación o perfiles de autor.
Uso de herramientas de investigación SEO para priorizar el trabajo de Schema
Schema no debería residir en un backlog técnico separado. Lo priorizo junto con la investigación de palabras clave, SERP, enlaces internos y backlinks, ya que esos conjuntos de datos identifican dónde los datos estructurados tienen una posibilidad realista de mejorar la experiencia de búsqueda.
Comienzo con páginas que se clasifican en la mitad de la primera página y en la parte superior de la segunda página para consultas comerciales o transaccionales. Luego comparo sus impresiones y el comportamiento de clics en Search Console. Una página que ya genera impresiones pero carece de un producto elegible, migas de pan, video o mejora local es un candidato más fuerte que una página sin demanda de consulta significativa.
Deja que la evidencia de SERP elija el tipo de schema
El seguimiento de funciones SERP muestra si la familia de consultas objetivo muestra resultados de productos, enlaces de sitio, información de eventos, resultados de video u otras mejoras. Esa observación determina el marcado a probar. No agrego FAQPage porque un plugin lo hace fácil. Lo agrego solo cuando la página contiene un recurso útil y visible de preguntas y respuestas y el marcado sirve para la legibilidad de la máquina.
Los informes de backlinks y enlaces internos agregan otro filtro. Una URL de receta o producto enterrada más allá de la estructura de navegación útil del sitio puede seguir siendo difícil de descubrir, incluso cuando su esquema es perfecto. Corregir páginas huérfanas y rutas internas débiles puede ser un requisito previo para el trabajo de esquema.
El flujo de trabajo es sencillo:
- Encuentra consultas con una oportunidad relevante de resultados enriquecidos.
- Mapea cada consulta a la URL clasificada.
- Confirma la elegibilidad de la URL y la brecha de esquema.
- Valida el contenido visible y los campos de datos de la página.
- Pon en cola la implementación según el valor comercial esperado.
Para un proceso más amplio que cubra brechas de palabras clave, análisis de SERP y descubrimiento de backlinks, usaría esta guía para herramientas de investigación SEO. La clave es hacer del esquema un resultado de la investigación. Eso evita que los equipos pasen semanas puliendo el marcado en URL que no tienen oportunidades de búsqueda o barreras técnicas no resueltas.
Tu lista de verificación de datos estructurados y qué ver a continuación
Si tuviera una semana para hacer que un programa de esquema sea útil, no comenzaría agregando nuevos tipos. Pasaría los primeros tres días auditando la cobertura en las URL de Article, Product y LocalBusiness, luego tomaría una muestra 10% de esas URL con la Prueba de Resultados Enriquecidos. Esa cifra de muestreo es una elección operativa interna para una auditoría práctica, no un requisito de Google.
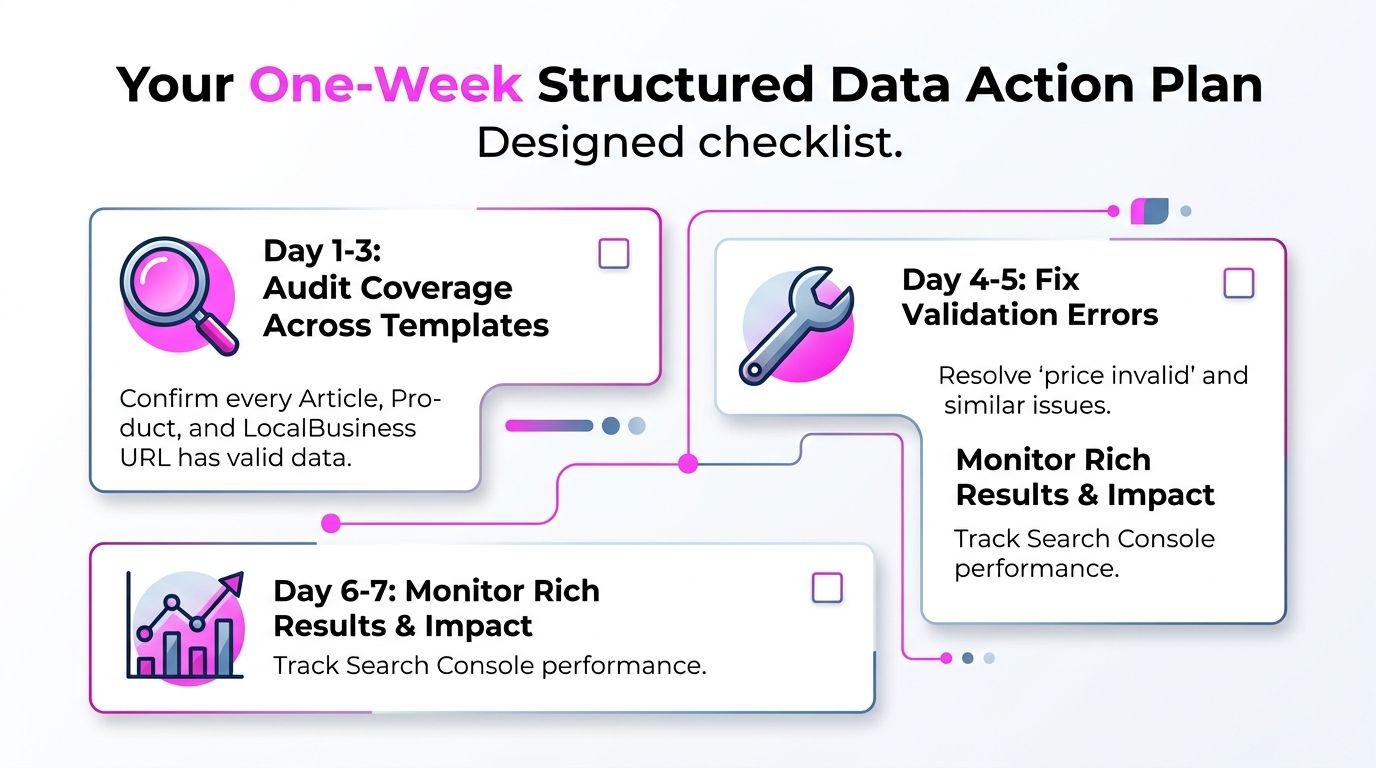
Mi primera semana
Días 1 a 3 ir al inventario de URL, clasificación de plantillas y validación. Confirmo que cada URL prioritaria emite el JSON-LD previsto y que sus propiedades coinciden con el contenido visible. También registro las páginas bloqueadas, noindexadas, inaccesibles e incompletas por separado, porque cada una necesita una solución diferente.
Días 4 y 5 ir a las categorías de error más comunes. Las imágenes, autores y precios que faltan suelen indicar problemas en los campos de origen o en las plantillas condicionales. Corrijo esos problemas en la capa de datos y luego vuelvo a ejecutar la validación en las páginas de cada plantilla afectada.
Días 6 y 7 ir a la medición. Envío el sitemap, inspecciono las URL prioritarias tal como las ve Google y etiqueto grupos de consultas donde un resultado enriquecido podría afectar plausiblemente al listado. Google Flujo de trabajo de implementación del conjunto de datos recomienda añadir las propiedades requeridas, validar con la Prueba de Resultados Enriquecidos, corregir errores críticos, implementar algunas páginas, inspeccionarlas y mantener a Google actualizado a través de un sitemap.
Lo que pospondría
Aplazaría tipos long-tail como Course o JobPosting cuando las páginas relevantes tengan poca demanda de búsqueda o datos de origen incompletos. También pospondría el marcado que necesita revisión de políticas para contenido de pago, restringido por inicio de sesión o gubernamental hasta que el acceso y la elegibilidad estén claros.
Mensualmente, revisaría los informes de mejoras de Search Console, compararía los cambios en las tasas de clics para grupos de consultas etiquetados y volvería a auditar después de que Google retire o restrinja un tipo de resultado enriquecido. FAQPage es un buen ejemplo de por qué esto es importante. El marcado que alguna vez tuvo un beneficio visible en la búsqueda puede servir más tarde principalmente como una capa de relación legible por máquina.
El activo duradero es un inventario de esquemas vivo. Las plantillas cambian, los campos del CMS cambian de nombre, los precios caducan, los autores se mudan y las funciones de búsqueda desaparecen. Trata los datos estructurados como la analítica. Configúralos cuidadosamente, valídalos continuamente y asigna a alguien la propiedad de las comprobaciones.
Utiliza SemDash para conectar la investigación de palabras clave, SERP, competencia y enlaces con las brechas de esquema a nivel de URL que merecen atención primero. Comienza identificando páginas con oportunidades de búsqueda reales, luego usa los flujos de trabajo de investigación y seguimiento de la plataforma para priorizar la implementación que puedas validar y medir.