La mayoría de los consejos sobre canibalización de palabras clave empiezan en el lugar equivocado. Si veo dos URL clasificadas para una palabra clave, no lo llamo un problema todavía, lo llamo una pista. El problema suele ser la inestabilidad de la propiedad de la consulta, donde Google cambia constantemente entre páginas, superficies o intenciones en lugar de decidirse por una URL claramente preferida.
Esa distinción es importante porque muchos equipos fusionan páginas demasiado pronto y dañan la cobertura que necesitaban. Una consulta puede parecer duplicada en una hoja de cálculo y seguir siendo saludable si una página posee la intención principal mientras que otra satisface una necesidad más específica. La auditoría en la que confío comienza haciendo una pregunta más difícil, ¿qué URL está ganando esa consulta con el tiempo y es el ganador estable?
Tabla de contenido
- Por qué la mayoría de los diagnósticos de canibalización son erróneos
- Creación de tu mapa de consultas a páginas de Search Console
- Superposición de búsquedas en el sitio, rastreo y verificaciones del historial de clasificación
- Cuatro pruebas que separan la canibalización real del ruido
- Cómo es una auditoría real en realidad
- Calificando y Priorizando las Consultas que Vale la Pena Arreglar
- Lista de verificación de auditoría y qué viene después de la identificación
Por qué la mayoría de los diagnósticos de canibalización son erróneos
El diagnóstico rápido, “dos URLs clasifican para una palabra clave”, capta demasiado ruido. He visto equipos colapsar páginas que servían diferentes intenciones, y luego pasar meses reconstruyendo el tráfico de cola larga que podrían haber conservado. La definición más segura es más estrecha, una consulta se canibaliza cuando la propiedad cambia constantemente entre páginas durante las últimas semanas, el CTR se retrasa con respecto a lo que sugieren las impresiones combinadas, y ninguna página mantiene una posición estable.
Es por eso que una sola instantánea es una evidencia débil. Search Console puede mostrar superposición sin probar daño, y la superposición amplia es a veces una competencia interna normal en lugar de un problema estructural, especialmente cuando una URL es claramente dominante. El punto de referencia práctico que utilizo es si la consulta muestra URLs competidoras con títulos o H1 similares, impresiones superpuestas y un patrón de cambio de URL, no solo resultados coexistentes.
Lo que busco antes de llamarlo canibalización
Una auditoría limpia separa tres situaciones que a menudo se agrupan:
- Segmentación de intención, donde dos páginas comparten un tema pero satisfacen diferentes necesidades.
- Desplazamiento de SERP, donde las funciones de IA u otros tipos de resultados mueven las URL orgánicas.
- Canibalización real, donde Google no puede decidirse por una página porque el sitio sigue enviando señales mixtas.
Ese planteamiento se alinea con los flujos de trabajo modernos de Search Console que exportan consultas y páginas, cuentan URL distintas por consulta y verifican la propiedad alternante de URL a lo largo del tiempo en lugar de depender de una única vista de los datos. También coincide con el consejo de comparar la superposición estable a lo largo de las semanas en lugar de una única instantánea de clasificación, porque la volatilidad es lo que expone el problema subyacente. Una búsqueda rápida site:yourdomain.com keyword puede ayudar, pero es solo un paso de selección, no una prueba, ya que muestra señales de relevancia e indexación, no datos completos de impresiones o clics. Como se señaló en la guía anterior de Search Engine Journal, la heurística más sólida sigue siendo una consulta con 2 o más URL competidoras, títulos similares e impresiones superpuestas.
Creación de tu mapa de consultas a páginas de Search Console
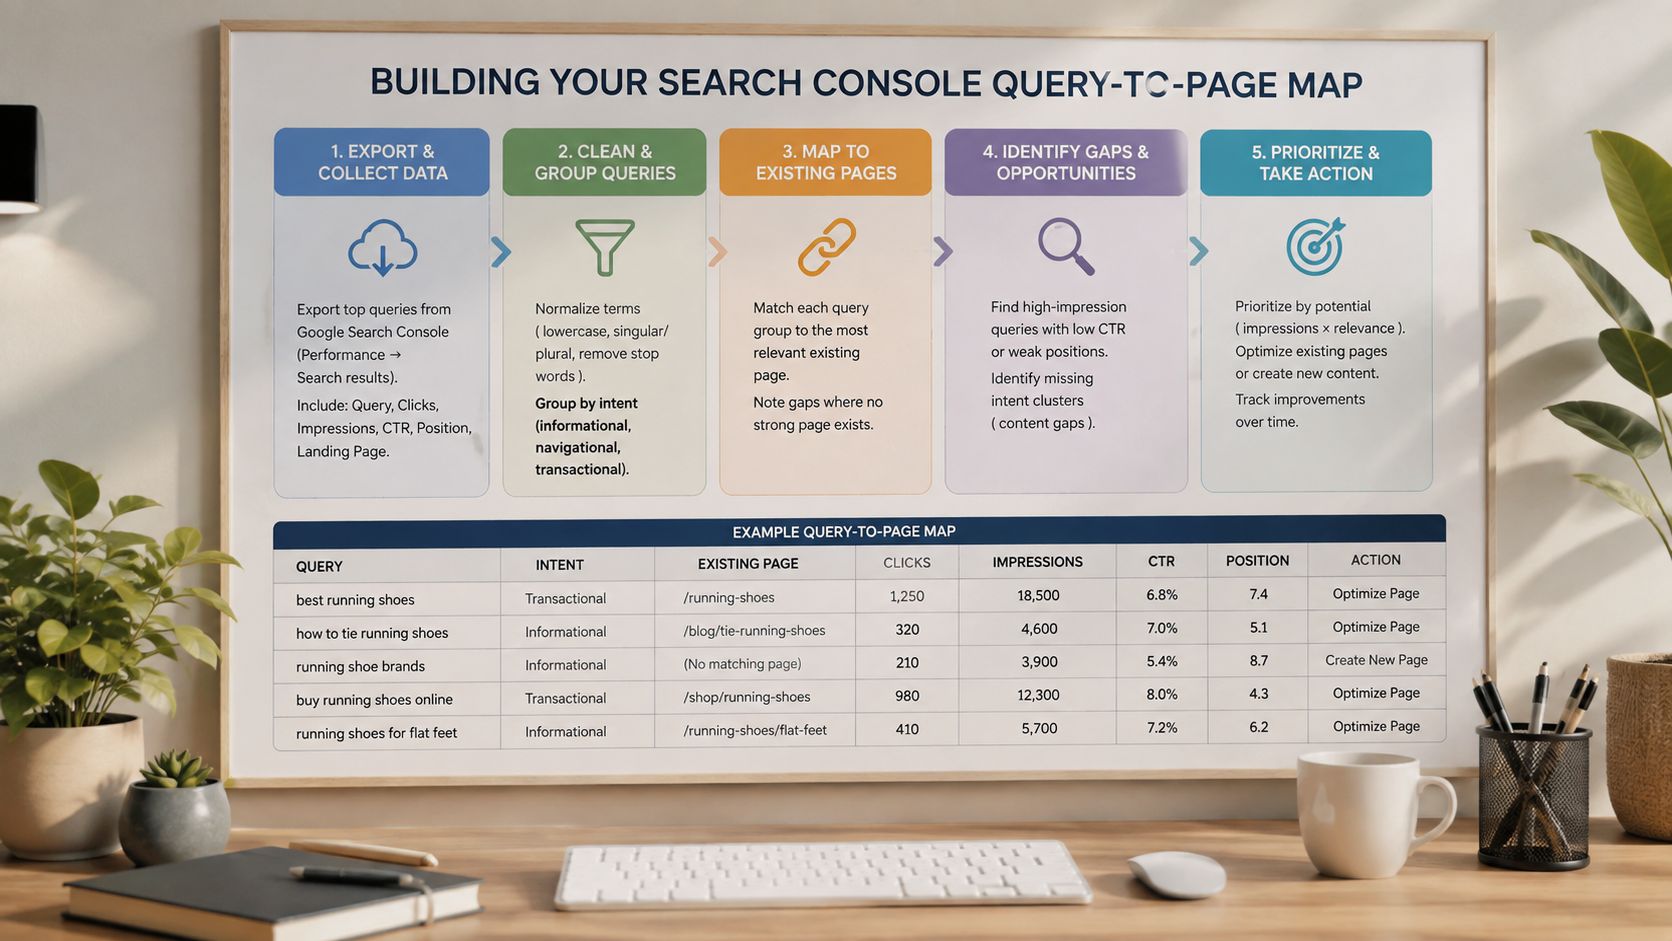
La forma más limpia que he encontrado para identificar la canibalización de palabras clave es empezar con los datos de rendimiento de Search Console, no con una exportación de rastreo o un rastreador de clasificación. Primero extraigo las últimas 16 semanas de consultas y páginas, porque esa ventana es lo suficientemente larga como para captar el comportamiento de cambio sin arrastrar un historial obsoleto que enturbie el patrón. Si un sitio es grande, establezco un filtro de trabajo en más de 50 impresiones para que la hoja de cálculo se centre en las consultas que pueden generar tráfico.
El flujo de trabajo de mapeo que utilizo
- Exporta las consultas y las páginas por separado. Mantengo los archivos sin procesar intactos y normalizo las URL antes de agregar nada. Eso es importante porque las agrupaciones de subcarpetas, las variantes de parámetros y las inconsistencias de barras diagonales finales pueden hacer que una página parezca varias.
- Crea un mapa de consultas a páginas. En una hoja de cálculo o Looker Studio, enumera cada consulta y cada página que recibió impresiones para ella, luego agrega clics, CTR y posición promedio. La posición promedio por sí sola puede ser engañosa, porque una página que aparece en muchos SERP mixtos puede mostrar un promedio decente mientras aún pierde la propiedad.
- Cuenta las URL distintas por consulta. Marco las consultas con 2 o más URL que reciben impresiones, luego ignoro los casos en los que la URL secundaria contribuye menos del 5% de los clics totales. Eso evita que la superposición benigna contamine la cola de revisión.
- Ordena por concentración de cuota de clics. Si ninguna URL individual posee más del 70% de los clics, trato la consulta como un candidato serio.
Regla práctica: Si el mapa de consulta a página cambia de una semana a otra, me importa más que la cantidad bruta de páginas.
El rango de fechas importa porque el comportamiento de cambio es temporal. He visto consultas que se ven limpias en una instantánea de 28 días y desordenadas en una exportación de 16 semanas. La ventana más amplia también me ayuda a separar páginas superpuestas de diferencias legítimas de formato, como URL de imágenes, videos o resultados de productos que pueden aparecer junto a páginas estándar.
Una buena hoja de auditoría también debe tener un campo de notas simple para cada consulta, para que pueda registrar si la superposición parece ruido de indexación, duplicación de contenido o inestabilidad real de propiedad. Ese registro se convierte en el rastro de evidencia cuando llega el momento de decidir si consolidar, canonizar o dejar las páginas solas.
Superposición de búsquedas en el sitio, rastreo y verificaciones del historial de clasificación
Una lista de GSC es solo el primer filtro. Valido cada candidato con tres capas para no contar la misma señal dos veces en diferentes herramientas. La secuencia importa, porque una página puede parecer competitiva en Search Console y luego resultar ser una superposición inofensiva una vez que reviso la intención, la indexación y el historial de clasificación juntos.
Cómo valido una consulta candidata
Primero, uso el site: operador para la consulta exacta e inspecciono qué URLs Google ya asocia con ella. Esa búsqueda rápida me da una idea del tipo de fragmento, los sitelinks y si un Resumen de IA u otra superficie de resultados puede estar desplazando los clics orgánicos en lugar de desencadenar un conflicto clásico de página contra página. Es un paso de selección, no un veredicto.
Segundo, rastreo las URLs candidatas. Busco superposición escasa, copia de plantilla compartida, duplicación de hreflang y texto de anclaje interno que dirige a Google hacia la página más débil. Si el rastreo muestra las mismas señales de intención en ambas URLs, lo considero una confirmación. Si las páginas divergen claramente, marco la superposición como intencional y sigo adelante.
Tercero, reviso el historial de clasificación en una ventana móvil. Utilizo herramientas como AccuRanker, Semrush o extracciones diarias de Search Console, y he descubierto que el patrón de cambio de URL importa mucho más que una sola caída de posición. Si la URL principal cambia constantemente para la misma consulta, es una fuerte señal de que el sitio no ha establecido una propiedad clara.
Para los equipos que desean una capa de seguimiento más amplia, la guía de seguimiento de clasificación con IA es útil porque enmarca el movimiento de clasificación en torno a los cambios a nivel de URL en lugar de solo la posición de la palabra clave. Eso se adapta mejor al trabajo de canibalización que los paneles que aplanan todo en una única posición promedio.
| Capa | Herramienta o Fuente | Lo que confirma | Supera el umbral |
|---|---|---|---|
| Visibilidad en búsquedas | Google Search Console | Múltiples URL que obtienen impresiones para la misma consulta | 2 o más URL competidoras |
| Comprobación de índice y SERP | site: Revisión de búsqueda y SERP en vivo |
Qué URL Google ya asocia con el término, además del contexto de fragmentos y la superficie de IA | Aparecen más de una URL relevante |
| Revisión del historial | Rastreador de clasificación o extracciones diarias de GSC | Si la propiedad es estable o alterna | Cambio repetido de URL a lo largo del tiempo |
Un candidato solo avanza si al menos dos de las tres capas muestran de forma independiente competencia activa. Esa regla evita que reaccione exageradamente a la volatilidad normal. También me da una nota defendible en el archivo de auditoría, lo que importa cuando un cliente pregunta más tarde por qué una página se dejó intacta y otra se consolidó.
Para el diagnóstico basado en rastreo, también mantengo un control sobre los controles de índice. La guía interna en manejo de etiquetas meta robots es relevante cuando la página más débil necesita permanecer accesible para los usuarios pero no competir en búsquedas.
Cuatro pruebas que separan la canibalización real del ruido
La forma más rápida de evitar malas fusiones es probar la superposición con el comportamiento, no solo con las palabras clave. Utilizo cuatro comprobaciones porque cada una detecta un modo de fallo diferente. Una página puede pasar una prueba y seguir siendo un mal candidato de consolidación si otra prueba muestra una clara separación de intenciones.
El marco de las cuatro pruebas
Prueba 1, frecuencia de cambio. Mapeo el movimiento de clasificación a lo largo de 90 días y marco solo las consultas donde dos URL se alternan dentro del top 10 al menos tres veces. Ese patrón es difícil de descartar como ruido de clasificación ordinario.
Prueba 2, correlación de funciones SERP. Comparo la superposición con la SERP en vivo. Si la pérdida de página solo aparece después de que las Vistas Previas de IA o los cuadros PAA desplacen los listados orgánicos, lo trato como desplazamiento, no como canibalización.
Prueba 3, gradiente de intención. Comparo títulos, H1s y la cobertura de entidades del primer párrafo. Si una página es informativa y la otra transaccional, o una sirve a principiantes mientras que la otra a usuarios avanzados, la superposición puede ser una segmentación saludable.
Prueba 4, distribución de CTR. Si las impresiones se dividen entre dos URLs pero los clics están por debajo de lo que generaría una sola página más fuerte, eso es inventario desperdiciado. El problema no es solo que existan dos páginas, sino que ninguna está convirtiendo la atención disponible de manera eficiente.
| Prueba | Qué Mide | Señal de Canibalización Real | Señal de Ruido |
|---|---|---|---|
| Frecuencia de alternancia | Propiedad de la URL a lo largo del tiempo | Dos URLs se alternan repetidamente | Una URL se mantiene dominante |
| Correlación de funciones SERP | Desplazamiento orgánico | La pérdida coincide con la saturación de funciones | La superposición solo refleja la volatilidad de la SERP |
| Gradiente de intención | Necesidades de usuario distintas | Misma intención, misma audiencia, misma función de página | Clara división entre informacional y transaccional |
| Distribución de CTR | Eficiencia de clics | Impresiones divididas con clics combinados débiles | Una URL acapara los clics a pesar de la superposición |
Un ejemplo práctico ayuda. Para “best running shoes,” He visto que tanto un artículo de lista como una reseña posicionan, pero la intención de búsqueda cambia según el presupuesto y el caso de uso. Eso suele ser segmentación, porque cada página cubre una subintención diferente. Yo mantendría ambas y afinaría su enfoque.
Un mejor ejemplo de canibalización es “cómo reiniciar el iPhone.” Cuando la página de soporte de Apple y un blog se alternan entre los puestos 4 y 6, y el CTR combinado es menor de lo que un único resultado estable debería captar, el sitio está mostrando confusión. Eso no es un problema de ecosistema de contenidos, es un problema de propiedad de la consulta.
Una página no necesita ser idéntica a otra para canibalizarla. Solo necesita seguir robando la misma oportunidad de clic sin ganarla claramente.
Cómo es una auditoría real en realidad
En un sitio de comercio electrónico mediano con aproximadamente 2,400 URL de productos y categorías, empiezo extrayendo 16 meses de los datos de Search Console para que la demanda estacional no oculte el patrón. Esa visión más amplia es importante en sitios de comercio electrónico porque una consulta puede parecer estable durante un ciclo de compra e inestable en otro. Filtro las consultas que promedian más de 50 impresiones al mes y me quedo solo con aquellas que tienen 2 o más URLs posicionadas.
, luego agrupo por consulta y observo qué URLs aparecen con el tiempo. Para una consulta como “auriculares inalámbricos,” etiqueté cada par de URLs según la duración de su solapamiento y descubrí que una página de categoría y una guía de compra mantuvieron posiciones en el top 5 durante siete meses, alternándose semana a semana. Ese fue un caso real de canibalización, porque el liderazgo no dejaba de cambiar y ninguna de las dos páginas asumía un rol definitivo.
A continuación, integré un rastreo con Screaming Frog para revisar los enlaces internos. La página más débil tenía más anclas contextuales de las que debía, lo que explicaba parte de la confusión. La página más fuerte se estaba diluyendo debido a un patrón de navegación que se veía ordenado en el CMS pero caótico en los datos del rastreo.
El mismo conjunto de datos me dio una falsa pista sobre “auriculares inalámbricos para correr.” La exportación sin procesar parecía casi idéntica, pero las páginas se dividían claramente por intención, un artículo de lista y una página de producto. Abandoné el plan de redirección allí porque la consolidación habría perjudicado la cobertura de long-tail y eliminado una ruta útil para los compradores con una necesidad más específica.
Para los equipos que hacen esto a escala, el marco de trabajo para realizar una auditoría SEO para agencias es un buen aliado, porque obliga a que la revisión pase del descubrimiento a la priorización sin omitir el rastro de evidencias.
La lógica de pivote que utilicé
- Mantener juntos: misma consulta, misma intención, propiedad inestable.
- Separar: misma cadena de consulta, diferente audiencia o caso de uso.
- Posponer la acción: existe superposición, pero una URL acapara los clics de forma constante.
Ese último grupo es el que muchos equipos ignoran. Una página que se ve desordenada en una hoja de cálculo aún puede funcionar bien si Search Console muestra una URL dominante y ningún cambio de titularidad relevante. He aprendido a no "arreglar" esos casos solo porque la exportación se ve desprolija.
Calificando y Priorizando las Consultas que Vale la Pena Arreglar
Una vez que la lista de candidatos está limpia, califico cada consulta para no perder tiempo en solapamientos de bajo valor. Mi modelo usa cinco ejes, cada uno calificado 0 a 3. El objetivo no es la perfección matemática, sino separar las consultas que justifican una acción de aquellas que deben seguir en observación.
El modelo de puntuación que uso
- Filtro de volumen. Las impresiones mensuales más altas obtienen una puntuación mayor porque el beneficio potencial es mayor.
- Valor de ingresos o conversión. Un grupo de consultas comerciales importa más que un término informativo superficial.
- Volatilidad de posición. Más cambios de ranking por mes significan mayor inestabilidad.
- Déficit de CTR. Una brecha más amplia en comparación con la curva de clics proyectada para el primer puesto significa más demanda desaprovechada.
- Facilidad de corrección. Las páginas con contenido similar y una clara equidad de enlaces son más fáciles de arreglar limpiamente.
Agrupo todo lo que está por debajo 7/15 en "solo monitorizar". En mi experiencia, esas consultas suelen fallar la prueba de coste, el techo de recuperación es demasiado bajo o la intención es demasiado ambigua para arreglarlas de forma segura. Las consultas que obtienen una puntuación más alta pasan a "arreglar ahora" o "programar para el próximo sprint", dependiendo de lo directamente que se puedan resolver las páginas.
Si agrupas antes de puntuar, el flujo de trabajo de agrupación de palabras clave ayuda porque hace que los temas a nivel de página sean más obvios antes de empezar a decidir qué URL debería poseerlos.
| Criterio | Peso (0-3) | Qué puntuar | Umbral de acción |
|---|---|---|---|
| Impresiones mensuales promedio | 0-3 | Demanda y potencial | Un mayor volumen aumenta la prioridad |
| Ingresos o valor de conversión | 0-3 | Impacto en el negocio | El valor comercial impulsa hacia "arreglar ahora" |
| Volatilidad de la posición | 0-3 | Frecuencia de intercambio | Los intercambios frecuentes necesitan atención |
| Déficit de CTR | 0-3 | Pérdida frente a clics esperados | Un déficit claro aumenta la urgencia |
| Facilidad de remediación | 0-3 | Similitud y equidad de enlaces | Las correcciones más limpias obtienen mejores puntuaciones |
Usando el ejemplo anterior, "auriculares inalámbricos" normalmente obtendría una puntuación alta porque tiene valor comercial, volatilidad visible y una ruta de consolidación plausible. “Auriculares inalámbricos para correr” normalmente obtendría una puntuación más baja porque la división de intenciones es más clara y el caso de negocio para fusionar es débil. Prefiero monitorear esa segunda consulta que forzar una consolidación que difumine el descubrimiento de productos.
Barandilla: No apruebo ninguna fusión a menos que las páginas compartan una superposición de intenciones distintas que sea lo suficientemente fuerte como para justificar la pérdida de una URL.
Esa regla ha salvado más tráfico que cualquier hoja de cálculo de puntuación. La tentación de fusionar en exceso es real, especialmente cuando un cliente quiere una victoria rápida, pero la fusión incorrecta puede borrar una cobertura útil en el long tail.
Lista de verificación de auditoría y qué viene después de la identificación
Un flujo de trabajo de identificación limpio termina con una lista de verificación corta, no con una pila de exportaciones. Verifico la consulta en Search Console, mapeo cada URL que recibe impresiones, verifico los cambios semana a semana, ejecuto el site: pantalla, inspeccionar el rastreo y luego confirmar el historial de clasificación. Si la consulta pasa al menos dos de las tres capas de validación y obtiene una puntuación lo suficientemente alta como para importar, se le asigna un plan de resolución.
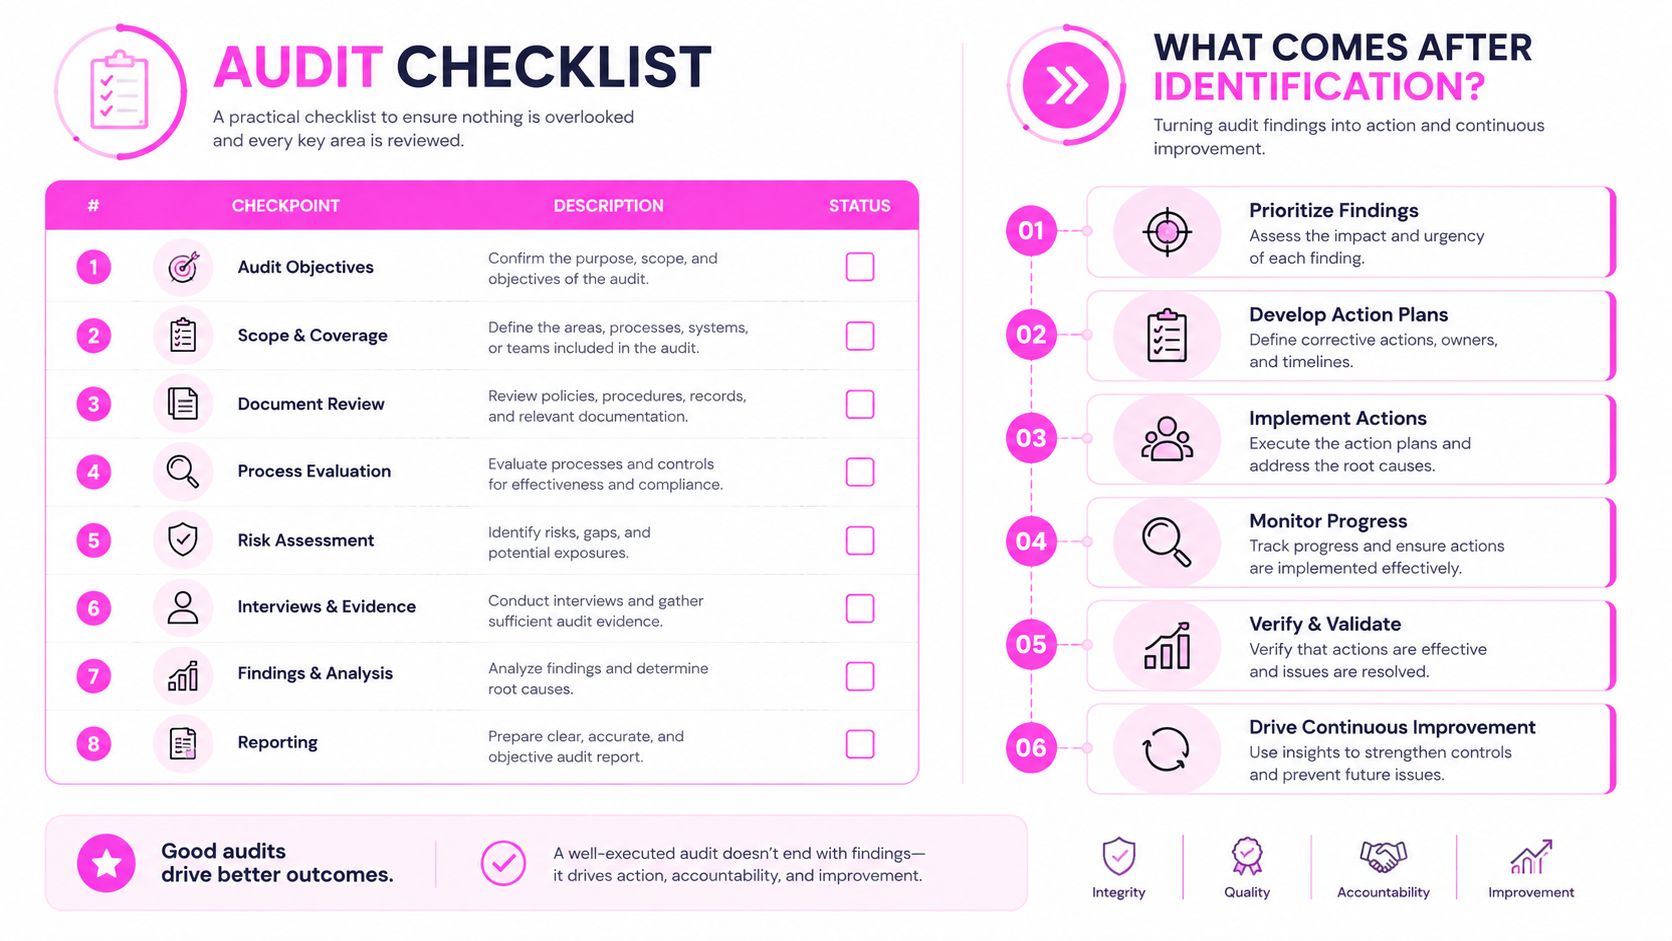
La ruta de acción que utilizo después de la identificación
- Canonicalizar duplicados cercanos cuando las páginas son efectivamente las mismas y ambas necesitan existir.
- Redirección 301 cuando una URL claramente posee el tema y la otra solo está debilitando la señal.
- Fusionar contenido solo cuando las páginas son estructuralmente redundantes y una página consolidada puede servir a ambas.
- Consolidar enlaces internos para que la página elegida reciba el mayor apoyo.
- Volver a comprobar en 30 días dentro de Search Console para confirmar que la propiedad de la consulta se ha estabilizado.
- Dejar de arreglar cuando la página muestra una propiedad estable y la superposición es intencional.
La mayor trampa es tratar cada par marcado como un candidato a fusión. Así es como los equipos matan variantes de intención útiles y pierden cobertura de cola larga de la que no se dieron cuenta que dependían. He tenido más éxito arreglando primero las consultas con propiedad inestable, y luego dejando la superposición intencional en paz cuando las señales muestran que está funcionando.
Si el patrón sigue siendo confuso después de una revisión de 30 días, vuelvo a examinar la intención y los enlaces internos antes de tocar el contenido en sí. La propiedad de la consulta generalmente te dice si el sitio necesita una reestructuración o solo señales más claras. Una vez que eso es estable, el problema deja de ser canibalización y se convierte en mantenimiento.
Si quieres una forma más rápida de detectar problemas de propiedad de consultas en páginas, palabras clave y SERPs, mira cómo SemDash mapea URLs superpuestas y clústeres de temas en un solo lugar. Uso herramientas como esa cuando quiero pasar del diagnóstico a la priorización sin perder el hilo entre Search Console, el historial de clasificación y la intención a nivel de página.